

何に困っていたか
僕たちは業務システムを、Lambda、DynamoDB、AppSync、SES、OpenSearch Serverless といったサーバーレスの部品で作っています。使っていない時間に費用を払わず、運用の手間も小さい。僕はこの組み方が好きです。変更は原則としてCDKのIaC経由にしています。例外は、CloudFormationで変えると置き換えが起きてしまうものだけです(後の節で書きます)。
ただ、サーバーレスには困った性質があります。部品ごとに細かな値の制約があり、それに触れると、処理が静かに失敗するのです。サーバーが落ちたなら監視が鳴ります。でも「メールが1通も送られていない」「下書きが保存できていない」「画面が何も出ない」は、利用者に言われるまで気づかないことがあります。
これまでの開発で、僕たちもそういう失敗を何度か踏んでいます。振り返ると、どれも制約そのものより、失敗したときに理由が残らない作りになっていたことが問題でした。この記事の結論はそこです。制約は覚えきれません。だから、ぶつかったときに理由が見える作りを先に入れます。
全体像と、3つの守り方
踏んだ失敗を並べると、守り方は3つに整理できました。
| 守り方 | 中身 | この記事の例 |
|---|---|---|
| 入口で弾く | 制約に触れる値を、保存や送信の前に変換するか、理由を付けて断る | SESのタグ、DynamoDBの400KB |
| 理由を残す | 失敗したら、例外の名前だけでなくメッセージまで記録し、画面にも分かる形で返す | SESの送信、AppSyncのエラー |
| 本番の形で確かめる | 仕様書や推測ではなく、実際の応答や差分を見てから「直った」と言う | AppSyncの応答、IaCの差分 |
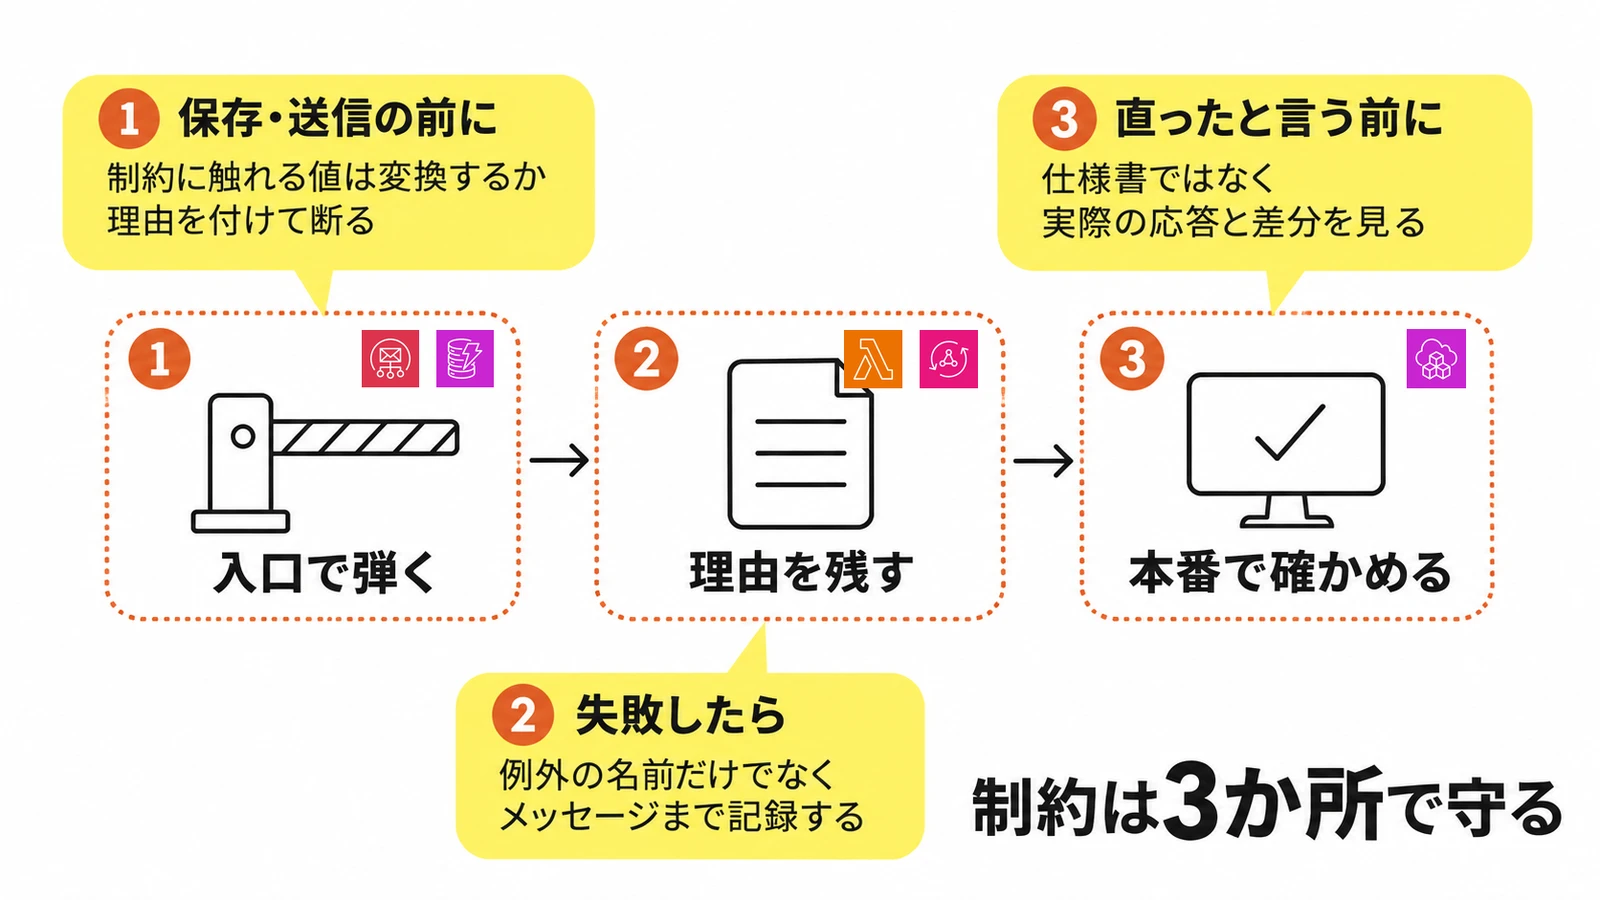
以下、実例ごとに、何が起きて、どう直したかを書きます。
SESのタグの値に「#」を入れて、送信が拒否された
メールの送信に SES v2 を使い、配信のイベントを後で集計するために、メッセージタグにテナントのIDを入れていました。そのIDは単一テーブル設計の流儀で Tenant#<uuid> の形です。
開発中に、このタグの値が原因で送信が拒否されました。SES v2 のメッセージタグの値に使える文字は限られていて、# は使えません。# を含む値を渡すと、SendEmail が BadRequestException で拒否されます。使える文字の正確な範囲は、SES v2 の API リファレンスの MessageTag の項で確かめてください。僕たちは、どの記載でも確実に使える英数字と - _ だけに収まる形にしました。
原因が見えるまでに時間がかかったのは、送信処理が例外の名前しか記録していなかったからです。BadRequestException だけでは、宛先が悪いのか、本文が悪いのか、タグが悪いのか分かりません。メッセージには Invalid tag value と出ていたのに、それを捨てていました。
直したのは2点です。タグの値は符号化して入れ、イベントを受ける側で戻す。失敗の理由は、メッセージごと記録する。
// タグの値に # は使えない。
// base64url は英数字と - _ だけで表せる(Node.js ではパディングの = も付かない)
const toTagValue = (s) => Buffer.from(s, 'utf8').toString('base64url');
const fromTagValue = (v) => Buffer.from(v, 'base64url').toString('utf8');

try {
  await ses.send(new SendEmailCommand({
    ...input,
    EmailTags: [{ Name: 'tenant', Value: toTagValue(tenantId) }],
  }));
} catch (e) {
  // 名前だけでなくメッセージまで残す。宛先のアドレスはそのまま出さない
  console.error(JSON.stringify({ event: 'send_failed', name: e.name, message: e.message }));
  throw e;
}
確かめ方も決めました。本物の宛先に試し打ちすると、誰かに本当にメールが届きます。SES のメールボックスシミュレーターの success@simulator.amazonses.com に、CLIから送って再現します。これなら、タグの値の問題だけを安全に切り分けられます。
DynamoDBの400KBを、貼り付けた画像が超えた
次は、開発中にリッチエディタの下書きが保存できなくなった件です。DynamoDB の1項目の上限は400KBです。普通の文章なら、まず届きません。
届いたのは画像でした。エディタに画像を貼ると、ブラウザーは画像を base64 の文字列にして本文に埋め込みます。数枚貼れば、本文だけで400KBを超えます。保存はエラーになりますが、画面に出るのは「保存に失敗しました」だけでした。
ここで捨てた選択肢があります。本文をS3に逃がし、DynamoDB にはキーだけを置く案です。確実に上限は避けられます。でも、すべての読み書きにS3の往復が1回増えますし、画像以外で400KBに届くことは実際にはありません。原因が画像なら、画像を本文に入れないのが筋です。
なので、画像は貼り付けた時点でアップロードし、本文にはURLだけを入れるようにしました。流れは「アップロード用のURLを発行する → ブラウザーから PUT する → 確定する」の3段で、公開APIの画像の扱いと同じ形にそろえています。
それでも上限に届く本文はあり得るので、保存の前にサーバー側で大きさを測り、理由を付けて断ります。測るのは、保存を担う Lambda の中です。AppSync の APPSYNC_JS のランタイムでは Node.js の Buffer が使えないので、大きさの計算は Lambda に置きました。
// Lambda(Node.js)で実行する。
// DynamoDB の項目の大きさは属性名と値の合計で決まる。
// JSON の大きさはその近似なので、余裕を持たせた値で断る
const LIMIT = 350 * 1024;

class ContentTooLargeError extends Error {
  constructor(message) {
    super(message);
    this.name = 'CONTENT_TOO_LARGE';
  }
}

export const assertItemSize = (item) => {
  const bytes = Buffer.byteLength(JSON.stringify(item), 'utf8');
  if (bytes > LIMIT) {
    throw new ContentTooLargeError('本文が大きすぎます。画像は貼り付けではなくアップロードしてください');
  }
};
JSON の大きさは、DynamoDB が数える大きさとぴったりは一致しません。だから上限の手前で断ります。ここは厳密さより、利用者に「なぜ保存できないか」が伝わることを優先しました。
AppSyncのエラー情報が、経路によってnullになる
3つ目は、開発中に画面の分岐が効かなかった件です。セッションが切れたら再ログインに誘導する、という分岐を、AppSync のエラーで判定していました。
APPSYNC_JS の util.error(message, errorType, data, errorInfo) は、errorInfo を応答に載せられます。そこに判定用のコードを入れていました。ところが、DynamoDB に直結したリゾルバーのように errorInfo を渡していない経路では、応答の errorInfo が null になります。画面は分岐できず、ただのエラーとして扱っていました。
直し方は単純です。画面が分岐に使うコードは、errorType そのものに入れます。'Unauthorized' のような分類名ではなく、'SESSION_EXPIRED' のように、画面が取るべき動きが分かる名前にします。
// リゾルバー側: 判定に使うコードは errorType に入れる
util.error('セッションの有効期限が切れました', 'SESSION_EXPIRED');

// 画面側: errorType で分岐する。対応表には必ずテストを置く
const ACTIONS = { SESSION_EXPIRED: 'relogin', CONTENT_TOO_LARGE: 'show_message' };
const action = ACTIONS[err.errorType] ?? 'show_generic';
この件で決めたことがもう1つあります。応答の形は、本番に curl を投げて確かめることです。仕様書を読んで「errorInfo に入るはず」と思い込んだのが、そもそもの原因でした。なお、僕たちの環境では、cdk deploy が終わってから AppSync の関数コードの変更が応答に出るまで、数分かかることがありました。公式の仕様として確かめたものではありませんが、直後に古い挙動が返っても、慌てずに少し待ってから確かめ直します。
IaCの変更が、黙って置き換えや空の画面を起こす
最後は、IaC 自体が静かに壊すケースです。2つあります。
1つ目は、タグの一括付与です。費用を集計するためのタグを、CDK で全リソースにまとめて付けようとしました。ところが OpenSearch Serverless のコレクションは、CloudFormation でタグを変えると置き換えになります。置き換えとは、作り直しです。インデックスが消えます。なので、コレクションだけは一括のタグから外し、例外として TagResource のAPIで付けました。原則は IaC 経由ですが、IaC で変えるとデータが消えるものだけは、事前に許可を取ったうえで API から変えます。タグ1つでも、部品ごとに振る舞いが違います。
2つ目は、デプロイの順番です。フロントエンドが push で自動デプロイされる構成で、先に push すると、新しい画面が古いスキーマに問い合わせて FieldUndefined になり、画面が空になります。順番は必ず cdk deploy が先、push が後です。
どちらも、事前に気づく手段はあります。cdk diff です。リゾルバーの論理IDが [-] と [+] の対で出ていたら、置き換えが起きます。いまは diff を読まずにデプロイしないことにしています。
試してやめたこと
制約の一覧表を作って、実装の前に全部確かめる運用も考えました。やめました。AWS の部品の制約は多く、しかも変わります。一覧は作った瞬間から古くなりますし、全部を事前に読むのは割に合いません。僕は、踏んだ制約を案件をまたぐ知見のノートに書き足し、AIが次の実装で読む形にしています。暗記ではなく、記録に覚えさせます。
失敗したら自動で再試行する、という作りも、この種の失敗には効きません。値が制約に触れているなら、何度送っても同じ理由で落ちます。再試行が効くのは、一時的な混雑や上限のような、時間で解消する失敗だけです。区別せずに再試行を入れると、理由が見えないまま失敗の回数だけが増えます。
エラーをすべて握りつぶして画面だけ正常に見せる作りも、当然やめています。利用者にとっては、失敗を知らされない方がずっと困ります。
次にやること
- 送信や保存の処理で、例外の名前しか残していない箇所を洗い出し、メッセージまで残す形にそろえる
- 画面が分岐に使う errorType の一覧を、全製品で共通の名前にそろえる
- cdk diff の結果に置き換えが含まれていたら、デプロイを止める仕組みを入れる
サーバーレスは、部品の制約を受け入れる代わりに、運用の手間と費用を下げる組み方です。僕はその取引を気に入っています。だからこそ、制約に触れたときに理由が見えることを、機能より先に作ります。皆さんは、制約にぶつかったときの理由をどこに残していますか。良いやり方があれば聞いてみたいです。
 (別タブで開きます)